↑↓ 选择↵ 打开⌫ 切换范围完整搜索

PG.CENTER 连接 PostgreSQL 文档、百科与生态知识。由 Pigsty 维护。

PostgreSQL 博览 RSS

保留原始来源与发布日期的新闻、博客和活动。

10 条内容

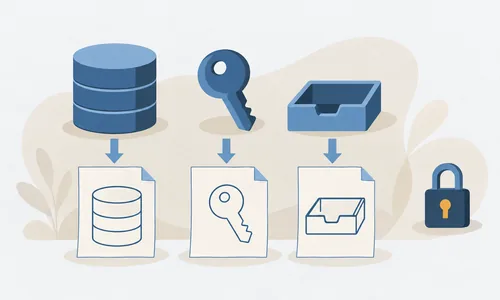
PostgreSQL 19 新增三个 pg_get_*_ddl 函数
Hubert depesz Lubaczewskidepesz.com

Andrew Dunstan 在 4 月 5 日提交了三个函数:pg_get_database_ddl()、pg_get_role_ddl() 和 pg_get_tablespace_ddl()。它们都返回 SETOF text,用变参的名值对传选项:pretty 分行排版,owner 带上属主,memberships 输出角色的 GRANT。两点限制要记住:输出里不会包含密码,函数也只重建对象本身,不含库内的表、视图等对象。
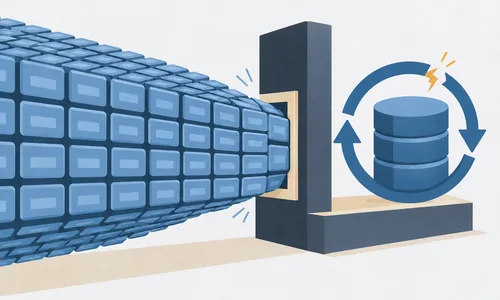
pg_prewarm 在超大 shared_buffers 上会崩溃

warda bibiStormatics

PostgreSQL 的 palloc 对单次分配有 1GB 硬上限,而 autoprewarm 转储缓存页时要一次分配整个数组,每条记录 20 字节,算下来 shared_buffers 超过约 429GB 就会越界。700GB 的机器需要约 1.75GB,于是报出 invalid memory alloc request size,后台进程随即陷入每分钟数百次的重启循环。根治要升到 PostgreSQL 16.10 以上。

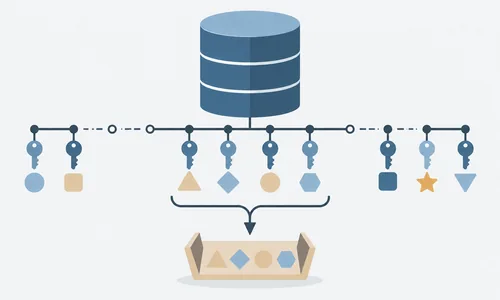
pgcollection 2.0 支持整数键与范围删除

Jim MlodgenskiJim Mlodgenski 博客

pgcollection 用关联数组帮 Oracle PL/SQL 代码搬到 PostgreSQL。2.0 新增整数键的 icollection,只存显式设过的键,避开原生数组用 NULL 填补稀疏下标的问题,键是 64 位整数、值可以是任意类型。delete() 现在支持删单键、删区间和清空并保留类型。要注意 Oracle 会自动给字符串键排序,pgcollection 保持插入顺序,需要时得自己调 sort()。

表膨胀会在高频写入下悄悄扩散

Jake HertzTigerData 博客

高频写入下,UPDATE 和 DELETE 留下的死元组积累速度会超过 autovacuum 回收的速度,页面碎片化,性能一路下滑。Jake Hertz 指出默认设置要等 20% 的行发生变化才触发清理,对大表意味着可以攒下几百万条死元组。文章给了测量膨胀率的查询,并建议把上亿行的高写入表的 autovacuum_vacuum_scale_factor 降到 0.01 到 0.02,让清理跑得更勤。

12 条内容

边缘 AI 把 PostgreSQL 当作事实来源

Vibhor KumarVibhor Kumar 博客

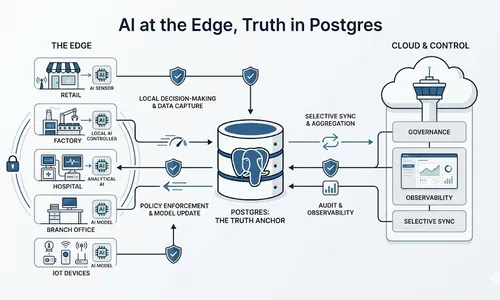
Vibhor Kumar 主张边缘 AI 的记录系统不能是概率性的:每个站点跑一个本地 PostgreSQL 作账本与策略边界,热数据留在本地,云端只做汇总、跨站分析与治理,两者之间靠 outbox 队列异步同步。落地要点包括用 INSERT ... ON CONFLICT 配稳定事件 ID 做幂等、把冲突规则写明而不是简单地后写覆盖、向量检索按租户与站点加上权限约束。他提醒 pgvector 0.8.2 的安全修复要尽快打上。

迁到 TimescaleDB 的最佳时机是一千万行

Matty StrattonTigerData 博客

Matty Stratton 给了一个时间点:一千万行左右迁移只是一个周末的活,拖到五亿行以上就变成几名工程师做几周的项目。他把中间这段时间的查询调优、扩机器和处理故障叫作优化税,是维持原生 PostgreSQL 性能的隐性开销。TimescaleDB 的原生压缩和自动分区把这部分负担去掉。文中没有给出具体基准,判断仍应结合自己的写入速率与查询形态。

AWS 把统一 JSON 搜索拆给六个服务

Ezat KarimiAWS 数据库博客

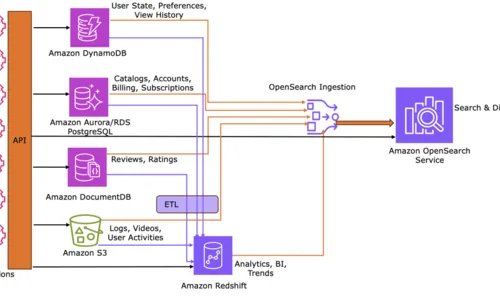
Ezat Karimi 的思路是不指望单一数据库扛下所有 JSON 场景。以视频平台为例,实时用户状态放 DynamoDB,影片目录放 DocumentDB,计费用 Aurora PostgreSQL 保证 ACID,数据湖落 S3,分析用 Redshift 的 SUPER 类型,内容发现交给 OpenSearch。各服务之间靠 OpenSearch Ingestion 做快照加持续变更捕获,在可接受的窗口内保持最终一致。

2 条内容