发布于 2026-09-10T10:59:44.089144Z · Jeremy Schneider · ardentperf.com
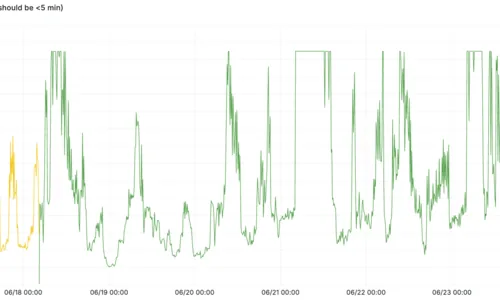
Jeremy Schneider 建议为检查点的总耗时单独设告警:在 checkpoint_timeout 保持默认 5 分钟的前提下,他倾向把阈值定在 15 分钟。更稳妥的做法是监控距离上一条检查点消息过去了多久,这样连停摆到不输出消息的情况也能发现,同时对“检查点过于频繁”告警,那通常意味着要调大 max_wal_size。他特别提醒,检查点停滞时千万不要重启数据库,重启可能让实例陷入恢复循环,把几小时的故障拖成几天。
Jeremy Schneider 建议为检查点的总耗时单独设告警:在 checkpoint_timeout 保持默认 5 分钟的前提下,他倾向把阈值定在 15 分钟。更稳妥的做法是监控距离上一条检查点消息过去了多久,这样连停摆到不输出消息的情况也能发现,同时对“检查点过于频繁”告警,那通常意味着要调大 max_wal_size。他特别提醒,检查点停滞时千万不要重启数据库,重启可能让实例陷入恢复循环,把几小时的故障拖成几天。
来源记录
- center.info_item · a0796edd9571dc49 · 2026-10-03T04:08:35.169032Z
- pgweb.info_item · a0796edd9571dc49 · 2026-10-03T04:08:55.967155Z