Huge Pages 从配置到验证的完整走法
大页把 TLB 覆盖的内存从 6MB 量级抬到 GB 量级,大幅减少 TLB 未命中。Christophe Pettus 给出完整步骤:用 shared_memory_size_in_huge_pages 算出需要多少页,96GB 缓冲池约需 49152 个 2MB 页;在内核命令行预留,再把 huge_pages 设为 on 而不是 try。透明大页设成 madvise 而非 always,启动后查 /proc/meminfo 核对。
保留原始来源与发布日期的新闻、博客和活动。
大页把 TLB 覆盖的内存从 6MB 量级抬到 GB 量级,大幅减少 TLB 未命中。Christophe Pettus 给出完整步骤:用 shared_memory_size_in_huge_pages 算出需要多少页,96GB 缓冲池约需 49152 个 2MB 页;在内核命令行预留,再把 huge_pages 设为 on 而不是 try。透明大页设成 madvise 而非 always,启动后查 /proc/meminfo 核对。
Christophe Pettus 把两种湖仓路线摆在一起看。pg_lake 是 Snowflake 那一路,作为扩展直接在 Postgres 后端读写 Iceberg 表与对象存储文件,本质是外部数据包装器,查询时把 OLTP 与湖仓联邦起来。Lakebase 走 Databricks 这一路,把 Neon 的存算分离搬进湖仓,本身就是湖仓里的无服务器 Postgres。前者适合已有两套系统一起查,后者适合要写时复制分支的负载。
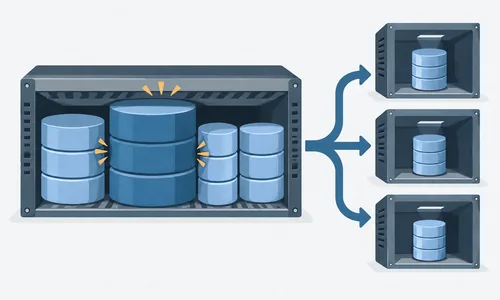
Shaun Thomas 说单实例多库撞到的往往不是硬件上限,而是共享资源。所有库抢同一份缓冲池,某个库扫 500GB 大表就会挤掉另一个库延迟敏感的热页;一个库疏于回收,事务 ID 回卷会让整个实例拒绝新事务;行级锁的 multixact 成员在实例级有 21GB 上限,一个库锁得凶就会拖住其他库;WAL 重放又是单线程,写入密集的主库产出速度可能结构性地超过副本的消化能力。他主张按库拆成独立实例。
表过了 5 亿行以后,连接带来的读放大和 CPU 开销会变成主要瓶颈。Jake Hertz 的做法是有选择地放弃范式:先用 pg_stat_statements 找出连接税落在哪些语句上,再把高频访问、低基数的元数据列迁进主表,把模式压平,省掉昂贵的连接;冗余出来的数据交给列式压缩处理。这样做减少了缓冲池压力和存储占用,把一个受 I/O 限制的系统变成 CPU 效率更高的系统。代价是写入侧要自己维护一致性。
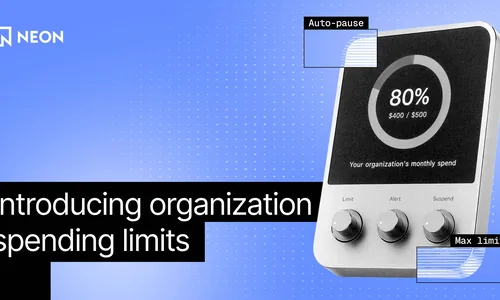
自动扩缩容的托管数据库最常见的抱怨,是流量一涨账单跟着失控,而多数云厂商只在费用产生之后才发通知。Neon 新增组织级消费上限,让团队为 PostgreSQL 负载预先设定预算阈值,把成本控制从事后告警挪到事前拦截。对按需扩缩的用法来说,这条限制决定了扩容会不会一路跑到月底才被发现,预算与自动扩容的边界需要一起规划。
Chao Li 发现 v10 到 v18 把微秒标成 ms,Fujii Masao 同时修掉了 v19 纳秒改动引入的溢出。
Dilip Kumar 说设计问题基本收敛,剩下的是确认这个内部模式不会被用户随手改动。
Shveta Malik 与 Amit Kapila 支持方案二,既不污染对外协议,也不必保留两条处理路径。
Michael Paquier 主张先测出错误命令静默成功的现状,再改 read_stream.c 与 bufmgr.c。