↑↓ 选择↵ 打开⌫ 切换范围完整搜索

PG.CENTER 连接 PostgreSQL 文档、百科与生态知识。由 Pigsty 维护。

PostgreSQL 博览 · 2026-08-28 RSS

保留原始来源与发布日期的新闻、博客和活动。

27 条内容

在线数据校验和功能面临从 v19 部分回退
Daniel Gustafssonpgsql-hackers

Daniel Gustafsson 提交了一个针对在线数据校验和功能的部分回退补丁,目标分支是 REL_19_STABLE,同时保留其中若干有独立价值的小修复。他的建议是只在 v19 回退、master 保留该功能以便继续开发,若遗留问题长期无人解决再考虑一并撤下。同一线程里 Alexander Lakhin 报告 buildfarm 上出现新的间歇失败,校验和状态返回 inprogress-off 而不是预期的 off。等这项特性落地的团队应按它可能不进 v19 来安排。
pg_dump 的纯数据转储会卡住自己的恢复

Mikhail ShytskoSeedfast 博客

把 pg_dump 的纯数据转储恢复进结构相同的空库,看起来最安全,Mikhail Shytsko 却复现了失败:\dt 里明明存在的 book_audit 表,导入时报 relation does not exist。原因是转储文件开头写了一行 set_config('search_path', '', false),会话的 search_path 被钉成空串,触发器函数里不带模式名的表引用随之解析不到。更常被提起的触发器重复写入审计行,要等触发器还能解析自身表时才遇得到。

多一个索引列的代价超过多一百万行数据

Damaso SanojaTiger Data 博客

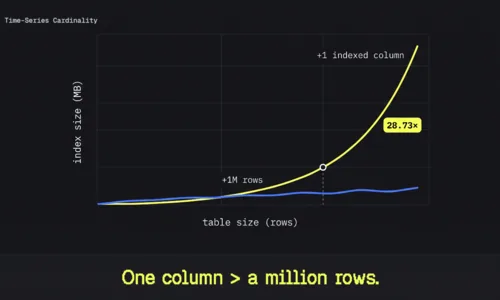
Damaso Sanoja 用 PostgreSQL 17.10 加 TimescaleDB 2.29.1、一亿行数据做基准:给宽表时序模式新增一个索引列会让索引体积增加 864.9 MB,而新增一百万行只增加 30.1 MB,相差 28.7 倍,同时写入吞吐下降约六分之一。原因是多维索引的乘性效应,每多一个索引维度,需要跟踪的序列数就成倍增长。文章给出的解法是模式规范化:把描述性字段拆进元数据表,事实表只留代理键作索引列。

ReViSQL-K2.6 用语义验证奖励微调 Text-to-SQL

Thinking MachinesThinking Machines

Thinking Machines 发布 Text-to-SQL 强化学习工作 ReViSQL-K2.6,并开放代码、数据与训练配方。作者审计了 2.5k 条 BIRD Train 样本,称其中 61.1% 至少含一种标注问题,于是用清洗后的 BIRD-Platinum、VeriEQL 语义等价校验和过程奖励微调 Kimi-K2.6,报告在 Arcwise-Plat-SQL 上以 16 次采样达到 92.97%。这些基准与成本口径都是作者自述,未见独立复现。

Cloudflare 调整 DNS 缓存布局释放约 100 TB 内存

CloudflareCloudflare 博客

Cloudflare 披露 1.1.1.1 解析器 Big Pineapple 的五项 Rust 层优化:把数据换成不可变的 Box<[T]> 与 Box<str>、减少列表与指针、压缩字段、复用 scratch buffer。单条缓存净占用从 953 字节降到 420 字节,生产 p99 内存由 9.3 GB 降到 5.3 GB,全网工作集少了约 100 TB;插入吞吐从每秒 62.5 万条升到 89.3 万条。这些比例绑定特定数据形态,套用前需自行 profiling。