逐字节拆开 PostgreSQL 的 MVCC
Radim Marek 用 pageinspect 把 MVCC 拆到字节。元组头里两个 32 位事务号,t_xmin 记插入者、t_xmax 记删除或更新者,为 0 表示仍然活跃;t_infomask 用 HEAP_XMIN_COMMITTED 之类的位缓存提交状态。要点是 UPDATE 只追加新版本,旧版本等 VACUUM 回收;SELECT 首次碰到新数据会设提示位,把页标脏引出 IO。
保留原始来源与发布日期的新闻、博客和活动。
Radim Marek 用 pageinspect 把 MVCC 拆到字节。元组头里两个 32 位事务号,t_xmin 记插入者、t_xmax 记删除或更新者,为 0 表示仍然活跃;t_infomask 用 HEAP_XMIN_COMMITTED 之类的位缓存提交状态。要点是 UPDATE 只追加新版本,旧版本等 VACUUM 回收;SELECT 首次碰到新数据会设提示位,把页标脏引出 IO。
pgEdge 的 Shaun Thomas 讲分区表上的老问题:唯一约束和主键必须包含全部分区键列,因为每个分区各有索引,没有全局索引来判断某个值是否已存在于别的分区。他给了四种绕法:BEFORE INSERT 触发器扫全部分区,开销随分区数线性上升,200 万行从 7 秒涨到 25 秒;改为维护一张不分区的去重表,开销恒定约 2 倍,200 万行 14 秒;对去重表本身做哈希分区;或用 hashtextextended() 算去重键。
Neon 在 OpenAI Codex 市场上架了官方插件,用 MCP 把 Codex 与自家的 PostgreSQL 托管服务连起来。装上之后可以在 Codex 的对话里直接开库、建实例、改配置和查看资源,不用在 IDE 与控制台之间来回切。对已经把 AI 助手放进开发流程的团队,这意味着数据库操作也能用自然语言完成。
Tiger Data 的 Doug Pagnutti 讲 Ignition 的 SQL Historian 怎么接 TimescaleDB。Ignition 把标签历史写进 PostgreSQL,而行式存储是为事务设计的,面对窄表、只追加的时序数据并不合适。TimescaleDB 按时间自动切块,旧块转列式压缩,新块保持行式以维持写入速度。接法是关掉 Ignition 内置分区,把历史表转成超表,再加压缩与保留策略。
restore_tuple() 重建 varlena 头时丢掉压缩标志,压缩数据被当成未压缩读出乱码,补丁已验证。
Dilip Kumar 的补丁把复制冲突记进专用表,Nisha Moond 因无法干净应用要求重做基线。
Andres Freund 建议 GetLocalPinLimit() 返回 num_temp_buffers/4,代价是临时表预读距离变短。
6 月 25 至 26 日在瑞士 Rapperswil,第 9 届,英语与德语双轨,完整议程 4 月底公布。
5 月 5 日在比利时 Haasrode 举行,距布鲁塞尔约 25 公里,讲者名单与日程已上线。
PostgreSQL 19 可以在运行中的集群上开关数据校验和,不必再停机跑 pg_checksums。新增 pg_enable_data_checksums() 与 pg_disable_data_checksums(),两者都接受 cost_delay 与 cost_limit 控制 IO 强度。后台进程逐库把缓冲区标脏重算,状态先显示 inprogress-on 或 inprogress-off,等后端吸收屏障信号后才落定。
Lætitia Avrot 复核 Linux 7.0 改用 PREEMPT_LAZY 后 PostgreSQL 变慢的说法。Salvatore Dipietro 在 96 vCPU 的 Graviton4 上跑 pgbench,1024 客户端、100GB 共享缓冲区并关掉 huge_pages,得到 7.0 仅为 6.x 的 0.51 倍。打开透明大页后两者都回到 185k tps。结论是瓶颈在大缓冲池的 4KB 缺页,不是抢占模式。
Xata 把自家的 Postgres 平台以 Apache 2.0 开源,提供秒级分支、计算自动休眠和原生 Postgres 运行。分支走写时复制:按块存储加元数据索引,克隆时只复制索引块,真正写入才复制数据,TB 级库也能在数秒内分出一份。存储与计算分离,用 NVMe over Fabrics 把存储引擎暴露到网络上。开源部分基于 CloudNativePG 与 OpenEBS,多区域部署代码和 Xatastor 存储引擎仍闭源。
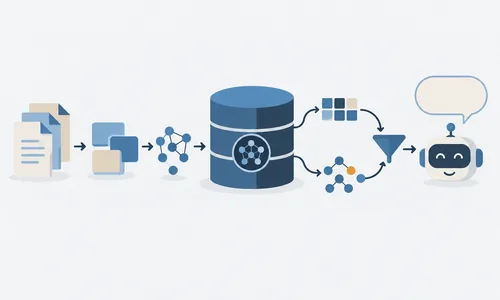
pgEdge 的 Ahsan Hadi 的系列第二篇讲 RAG Server 架构与配置。Vectorizer 是一个后台工作进程扩展,靠触发器盯住源表的写入,把文本按 400 令牌切块、重叠 50 令牌,调用嵌入提供者写进 pgvector,嵌入提供者可选 Ollama、OpenAI 或 Voyage AI。RAG Server 是 Go 写的 API 服务,做向量相似度与 BM25 的混合检索,按令牌预算截断后交 LLM 生成答案。
LogTide 是面向家庭实验室和小企业的开源可观测平台,目标是在 2GB 内存里每天处理数百万条日志。创始人 Giuseppe Pollio 选了 TimescaleDB 而不是 ClickHouse 或 MongoDB,理由是兼容 PostgreSQL。厂商口径的生产数据是列式压缩把 220GB 日志压到 25GB,查询快 33% 到 41%;典型批量下写入达每秒 14200 行,过滤查询比 MongoDB 快 650 倍。
Andrew Dunstan 推送后 OpenBSD 构建农场失败,pg_basebackup 测试也暴露出疑似竞态。
补丁修掉纯归档恢复下 standby_write 等待者可能永久休眠的边角情况。
Andres Freund 主张把死锁检测放进锁管理器,Antonin Houska 担心每次插锁都要取全部 LWLock。